Vision Transformer学习笔记
Vision Transformer学习笔记
总览:
先分把图像切成几个patches(比如每个patches大小为16*16)
让patches通过 Linear Projection of Flattened Patches(embedding层) 获得 token
加上位置信息
在最前面加上一个[class]token(参考BERT),用于classification
经过Transfomer Encoder,提取[class]的输出
最后通过MLP层得到最终输出
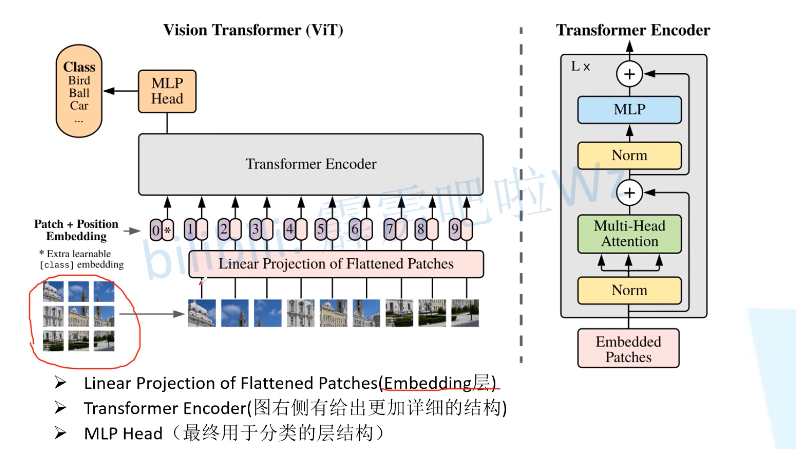
Embedding层
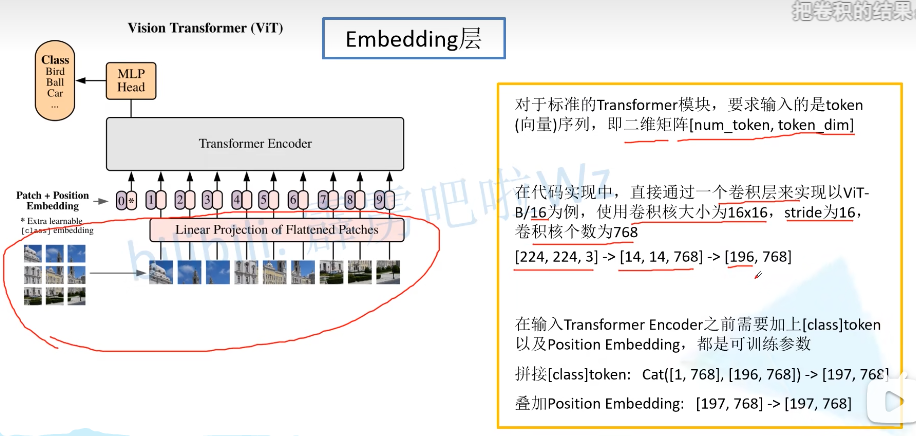
transformer要求输入token(向量)序列([num_token,token_dim]),跟图片维度[H,W,C]不符,需要embedding进行变换
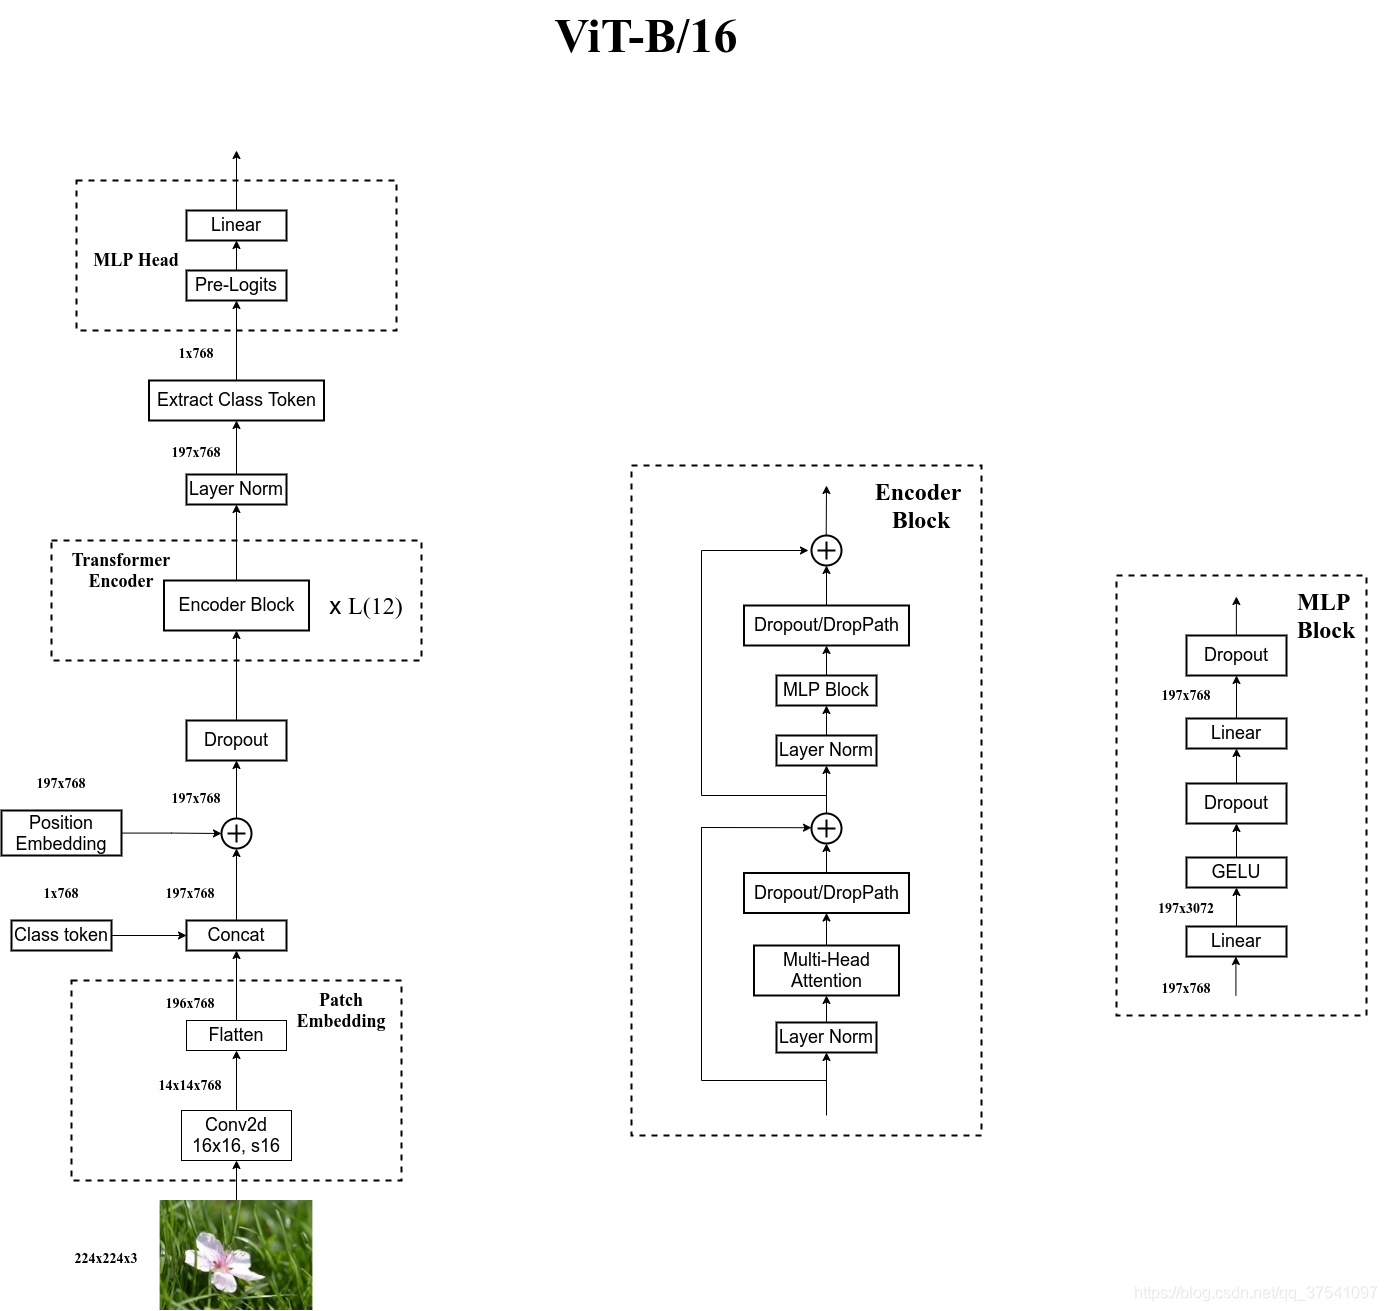
以ViT-B/16为例和(224,224)照片为例,按照 16 * 16 划分得到 196 个Patches,每个patches[16,16,3]通过映射得到长度768的token。
代码实现直接通过如图所示的参数(kernal_size=16,stride=16,out_channel=768 ),获得[196,768]的矩阵
然后加上[class]token(矩阵Cat([1, 768], [196, 768]) -> [197, 768])以及叠加Position Embedding(1D Pos. Emb. 直接叠加到tokens上)
Position Embedding
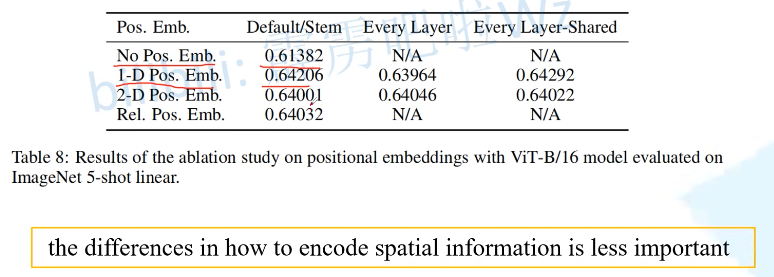
Position Embedding形式不重要,但是有没有很重要(差了3个点)
因为1D Pos. Emd.计算简单,便采用
Transformer Encoder
多个Encoder Block构成Transformer Encoder
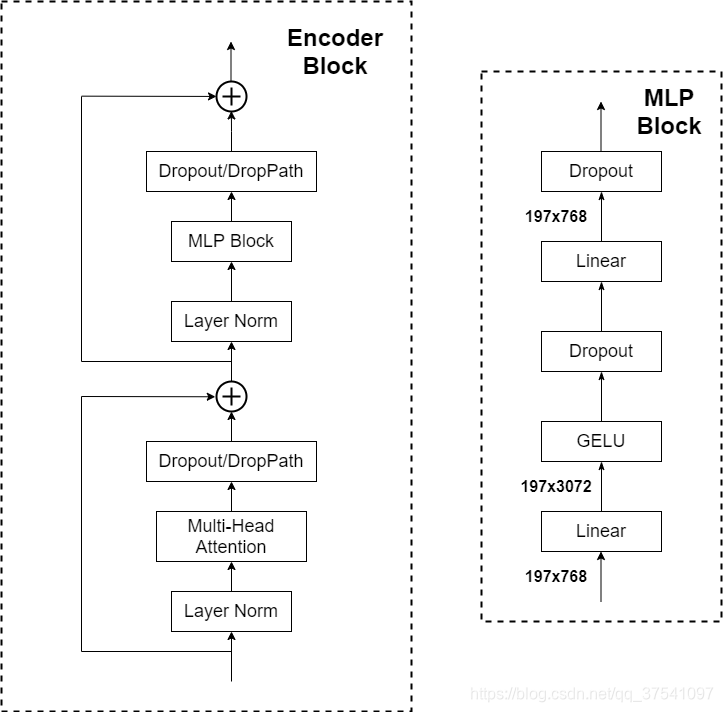
一个Encoder Block里有两小层,核心分别为多头注意力和MLP,多个Encoder Block构成Transformer Encoder
LayerNorm
针对自然语言处理领域提出的,应对时序的长度并不是一个定值(如每句话长度不同),难以使用BN
LN是单个数据的指定维度进行Norm处理(与Batch无关),BN是对于一个batch数据的每个channel进行Norm处理
原文使用的是Dropout,一些大佬用的是DropPath,可能后者效果会好一点
MLP Block里面是全连接+GELU激活函数+Dropout,第一个全连接层会把输入节点个数翻4倍[197, 768] -> [197, 3072],第二个全连接层会还原回原节点个数[197, 3072] -> [197, 768]
MLP Head
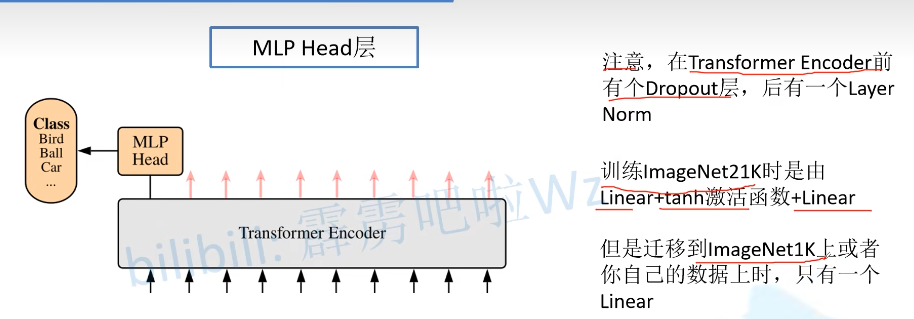
原论文中说在训练ImageNet21K时是由Linear+tanh激活函数+Linear组成。
但是迁移到ImageNet1K上或者自己的数据上时,只用一个Linear即可。
ViT-B/16架构
Vision Transformer学习笔记